
Limpiar datos con pandas: 10 pasos para dejar tu Excel listo para analizar
Limpia con pandas espacios, mayúsculas, números con coma decimal, fechas, vacíos y duplicados, y separa las filas que hay que revisar.
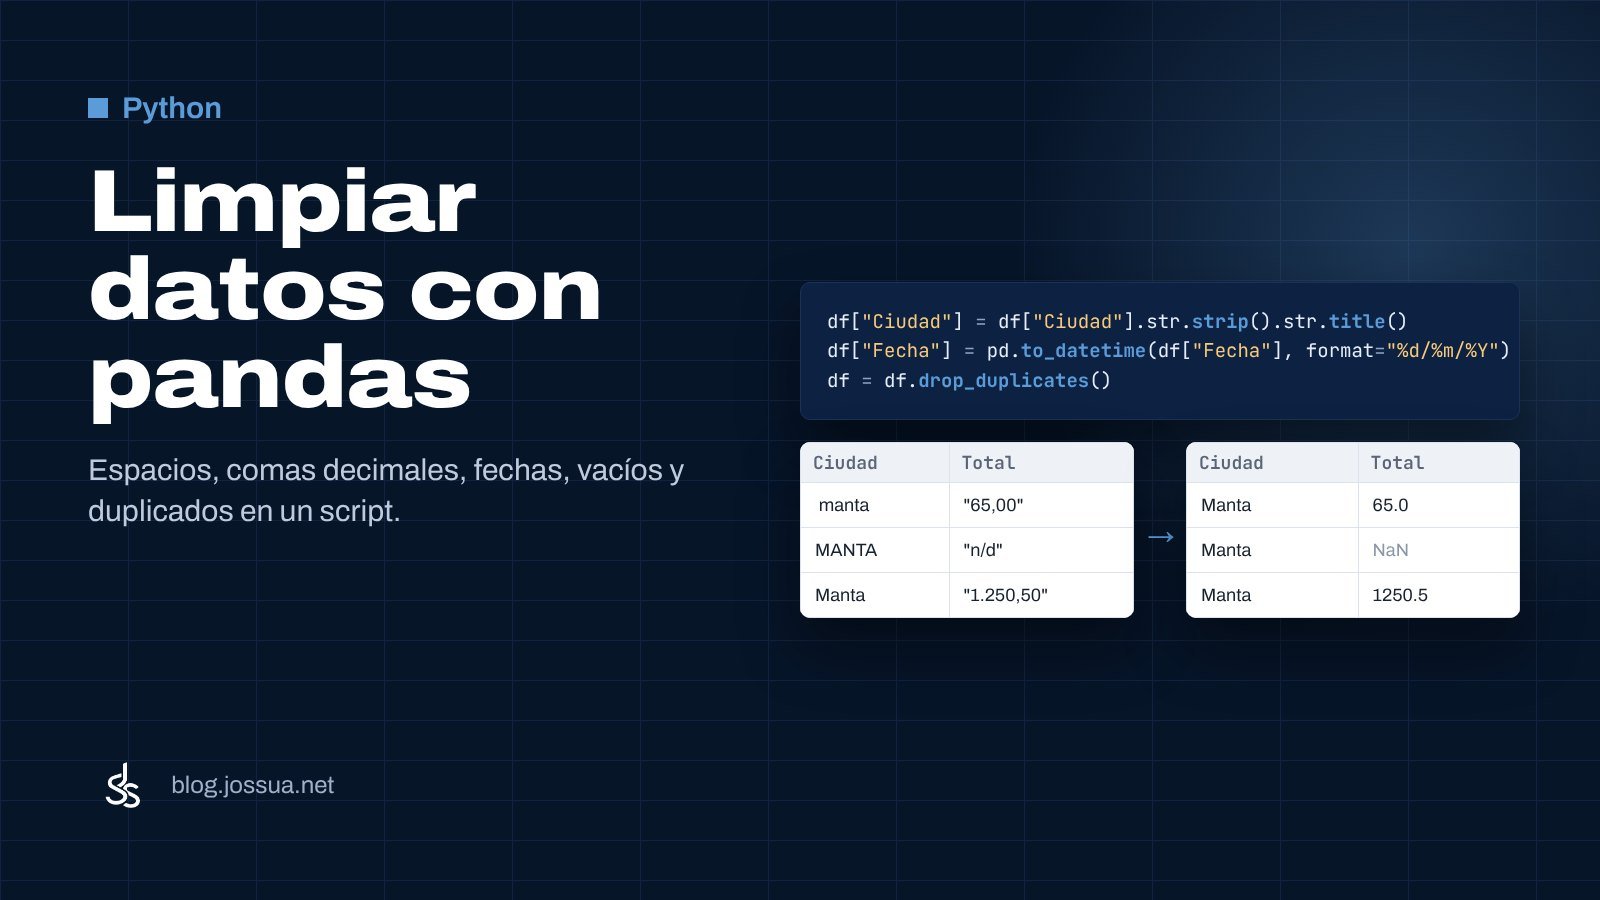
Antes de hacer cualquier tabla dinámica, gráfico o reporte, hay que limpiar los datos. Nombres con espacios de más, “MANTA” y “manta” como si fueran ciudades distintas, números con coma decimal que Python lee como texto, fechas vacías y filas repetidas. Si haces esa limpieza a mano cada mes, pierdes horas. Con pandas la escribes una vez en un script y la repites en segundos.
Si vienes de Excel y aún no conoces pandas, empieza por pandas para usuarios de Excel. Si prefieres no programar, la misma limpieza se puede hacer con Power Query.
El archivo de ejemplo
Trabajaremos con un listado de ventas exportado de un sistema, con los problemas típicos:
- Columnas como
Fecha(con espacios) yCLIENTE(en mayúsculas). - Clientes y ciudades escritos de varias formas:
" distribuidora costa","manta ","MANTA". - Precios y totales con coma decimal:
"6,50","1.250,50". - Valores como
"n/d"o"-"donde debería haber un número. - Una fila sin fecha, otra sin cliente y una venta repetida.
pip install pandas openpyxlPaso 1: leer todo como texto y revisar
import pandas as pd

df = pd.read_excel("ventas_sucias.xlsx", dtype=str)
print(df.shape)     # (filas, columnas)
df.info()           # tipos y cantidad de valores no vacíos
Leer con dtype=str evita que pandas adivine los tipos y transforme mal algunos valores. Tú decides después qué columna es número y cuál es fecha. df.info() te muestra de entrada cuántos vacíos tiene cada columna.
Paso 2: nombres de columnas limpios
df.columns = df.columns.str.strip().str.title()
print(df.columns.tolist())
# ['Fecha', 'Cliente', 'Ciudad', 'Producto', 'Cantidad', 'Precio', 'Total']
Un espacio invisible en un encabezado hace que df["Fecha"] falle con KeyError. Este paso lo evita para siempre.
Paso 3: espacios y mayúsculas en el texto
for col in ["Cliente", "Ciudad", "Producto"]:
    df[col] = df[col].str.strip()

df["Cliente"] = df["Cliente"].str.title()
df["Ciudad"] = df["Ciudad"].str.title()
str.strip() quita espacios al inicio y al final (como ESPACIOS en Excel) y str.title() pone la primera letra de cada palabra en mayúscula (como NOMPROPIO). Después de esto, “manta “, “MANTA” y “Manta” son la misma ciudad y tus agrupaciones dejarán de duplicarse.
Paso 4: números con coma decimal
for col in ["Precio", "Total"]:
    df[col] = (df[col].str.replace(".", "", regex=False)    # quita el separador de miles
                      .str.replace(",", ".", regex=False))  # coma decimal -> punto
    df[col] = pd.to_numeric(df[col], errors="coerce")

df["Cantidad"] = pd.to_numeric(df["Cantidad"], errors="coerce")
Python usa el punto como separador decimal. Primero se quita el punto de miles y luego la coma se cambia por punto, así "1.250,50" se convierte en 1250.5. Con errors="coerce", lo que no se pueda convertir ("n/d", "-") queda como vacío (NaN) en lugar de detener el script.
Paso 5: fechas
df["Fecha"] = pd.to_datetime(df["Fecha"], format="%d/%m/%Y", errors="coerce")
print(df.dtypes)
Indicar el formato (%d/%m/%Y = día/mes/año) es clave: sin él, pandas podría leer el 06/11/2026 como 11 de junio. Las fechas vacías o mal escritas quedan como NaT, el “vacío” de las fechas.
Paso 6: encontrar y tratar los vacíos
print(df.isna().sum())                    # vacíos por columna
problemas = df[df.isna().any(axis=1)]     # filas con al menos un vacío
print(problemas)

# Si falta el total pero hay cantidad y precio, se calcula
df["Total"] = df["Total"].fillna(df["Cantidad"] * df["Precio"])

# Sin fecha, cliente o cantidad, la fila no sirve para el análisis
df = df.dropna(subset=["Fecha", "Cliente", "Cantidad"])
Fíjate en que primero guardamos las filas con problemas en problemas. No se trata de borrar y olvidar: esas filas se entregan a quien maneja el sistema para que las corrija en el origen.
Rellenar no siempre es correcto. Completar un total con cantidad × precio tiene sentido. Inventar una fecha o un cliente, no. Decide columna por columna qué se puede calcular y qué se debe devolver para revisión.
Paso 7: duplicados
print("Duplicados:", df.duplicated().sum())
df = df.drop_duplicates()
Ojo: los duplicados se buscan después de limpiar el texto. Antes, “Bazar Lucía” y “Bazar Lucía ” (con un espacio) no se veían iguales. Si tus datos tienen un número de factura, es más seguro buscar duplicados solo por esa columna: df.drop_duplicates(subset=["Factura"]).
Paso 8: unificar nombres
df["Cliente"] = df["Cliente"].replace({
    "Ferreteria Andrade": "Ferretería Andrade",
    "Dist. Costa": "Distribuidora Costa",
})
Para los casos que ni strip ni title resuelven (abreviaturas, tildes faltantes), usa un diccionario de reemplazos. Si la lista crece, guárdala en un Excel aparte y léela con pandas.
Paso 9: validar que los números cuadren
recalculado = (df["Cantidad"] * df["Precio"]).round(2)
no_cuadra = df[(df["Total"] - recalculado).abs() > 0.01]
print("No cuadran:", len(no_cuadra))

print(df[df["Cantidad"] <= 0])   # cantidades cero o negativas
Una limpieza no termina cuando no hay errores de formato, sino cuando los datos tienen sentido. Revisar que el total sea cantidad × precio y que no haya cantidades negativas te ahorra presentar un reporte con números imposibles.
Paso 10: tipos finales y guardar
df["Cantidad"] = df["Cantidad"].astype(int)
df = df.sort_values("Fecha").reset_index(drop=True)

df.to_excel("ventas_limpias.xlsx", index=False)
problemas.to_excel("revisar.xlsx", index=False)
print("Listo:", len(df), "filas limpias")
Terminas con dos archivos: ventas_limpias.xlsx, listo para el análisis, y revisar.xlsx, con las filas que alguien debe corregir. A partir de aquí puedes resumir con groupby, graficar con matplotlib o darle formato al reporte con openpyxl.
Errores frecuentes
- KeyError: ‘Fecha’: el encabezado tiene espacios o tildes distintas. Ejecuta el paso 2 y revisa
df.columns.tolist(). - Los precios quedan multiplicados por 100: tus números ya venían con punto decimal (
6.50) y el paso 4 quitó el punto. Aplica ese paso solo a columnas con coma decimal. - Las fechas salen todas como NaT: el formato no coincide. Si vienen como
2026-11-05, usaformat="%Y-%m-%d". - No elimina duplicados que se ven iguales: aún hay diferencias de espacios o mayúsculas. Limpia el texto antes de
drop_duplicates. - Una columna de números sigue siendo texto: te faltó
pd.to_numeric. Comprueba siempre condf.dtypes.
Guarda este script con el nombre de tu reporte. El próximo mes solo cambias el archivo de entrada, lo ejecutas y tienes los datos limpios antes de terminar el café.

Comentarios
Todavía no hay comentarios. Si tienes una duda sobre este tema, escríbela aquí y te respondo.
Deja tu comentario